Setiap akhir bulan, divisi keuangan dan operasional di berbagai korporat Indonesia menghadapi pemandangan yang serupa: tumpukan ratusan berkas faktur fisik, surat jalan bertandatangan basah, dan formulir aplikasi yang harus diketik ulang satu per satu ke dalam sistem ERP. Proses entri data manual ini tidak sekadar membosankan, melainkan menyedot ribuan jam kerja produktif tahunan serta memicu tingkat kesalahan manusia (human error) rata-rata 1% hingga 4% yang berujung pada keterlambatan rekonsiliasi kas dan sengketa pembayaran vendor.
Kini, kehadiran teknologi AI OCR (Optical Character Recognition) berbasis Large Vision Models mengubah paradigma pemrosesan dokumen. Berbeda dari sistem OCR tradisional yang kaku dan mudah rusak saat format berkas bergeser satu milimeter, AI OCR mampu memahami tata letak visual selayaknya mata manusia, mengekstrak data tidak terstruktur menjadi payload JSON yang bersih, dan mengalirkannya langsung ke sistem database bisnis secara otomatis.
Dalam artikel ini, kita akan membedah arsitektur teknis di balik AI OCR modern, membandingkan performanya dengan sistem konvensional, serta menelaah alur implementasi praktis agar dokumen perusahaan dapat dikonversi menjadi data siap pakai secara aman dan patuh regulasi.
Daftar Isi
- Evolusi dari Template OCR Konvensional Menuju Vision AI
- Tabel Perbandingan: Entri Manual vs OCR Tradisional vs AI OCR Modern
- Arsitektur Pipeline: Dari Kertas Fisik Menjadi Payload JSON Terstruktur
- Integrasi dengan Ekosistem Otomasi dan AI Korporat
- Tantangan Keamanan Data dan Kepatuhan Regulasi di Indonesia
- Kesimpulan: Kapan Perusahaan Anda Harus Beralih?
- FAQ (Pertanyaan yang Sering Diajukan)
- Referensi & Tautan Berguna
Evolusi dari Template OCR Konvensional Menuju Vision AI
Untuk memahami mengapa investasi OCR generasi lama sering kali berujung kekecewaan di mata tim IT perusahaan, kita perlu membedah batasan teknis antara pendekatan berbasis koordinat geometris dengan pendekatan kognitif modern.
Sistem OCR tradisional (seperti implementasi awal Tesseract atau zonal-OCR) bekerja dengan aturan koordinat piksel statis (*bounding box*). Sistem mengharuskan dokumen dipindai tepat di posisi tertentu: kotak nama harus berada di koordinat X:100 Y:200. Jika vendor mengirimkan faktur dengan penataan baris yang sedikit berbeda, atau hasil pemindaian scanner sedikit miring (skewed), sistem koordinat ini gagal membaca konteks dan menghasilkan karakter sampah.
Sebaliknya, AI Document Processing modern menggabungkan arsitektur Vision Transformers (ViT) dan model bahasa multimodal. Sistem tidak peduli di koordinat mana total tagihan dicetak; model dilatih untuk mengenali semantik teks seperti “Total Tagihan”, “Grand Total”, atau “Jumlah yang Harus Dibayar”, lalu mencari nilai nominal numerik yang berada di sebelah kanan atau di bawah teks jangkar tersebut secara cerdas.
Tabel Perbandingan: Entri Manual vs OCR Tradisional vs AI OCR Modern
| Parameter Evaluasi | Entri Manual (Staf Khusus) | OCR Konvensional (Zonal) | Modern AI OCR (Vision Models) |
|---|---|---|---|
| Waktu Pemrosesan per Dokumen | 3 hingga 7 menit per lembar | 5 hingga 15 detik | Sub-detik (200ms – 1.2 detik) |
| Tingkat Akurasi Rata-rata | 94% – 97% (bergantung kelelahan) | 60% – 75% jika tata letak dinamis | 98.5% – 99.4% dengan self-correction |
| Penanganan Dokumen Kompleks | Tinggi (manusia fleksibel) | Sangat Rendah (wajib template kaku) | Tinggi (mengenali tabel tanpa batas & garis miring) |
| Ekstraksi Tabel Multi-Halaman | Sangat memakan waktu | Sering terpotong / kolom berantakan | Mampu merangkai baris multi-halaman ke array JSON |
| Biaya Skalabilitas (Saat Lonjakan Volume) | Eksponensial (harus rekrut staf lembur) | Menengah (biaya pemeliharaan template) | Linear dan dapat diprediksi via API Cloud/On-Prem |
Arsitektur Pipeline: Dari Kertas Fisik Menjadi Payload JSON Terstruktur
Bagaimana alur kerja teknis pemrosesan dokumen berjalan di lingkungan produksi korporat? Implementasi modern menerapkan pipeline asinkron empat tahap:
1. Tahap Pra-Pemrosesan Gambar (Image Pre-Processing):
File scan atau jepretan kamera smartphone karyawan dibersihkan dari bayangan, rotasi sudut otomatis diluruskan (deskewing), kontras teks dinaikkan melalui adaptive thresholding, dan artefak lipatan kertas disaring agar citra tajam.
2. Ekstraksi Tata Letak & Entitas Semantik (Layout Analysis & Entity Extraction):
Model visi membagi kanvas dokumen menjadi blok-blok semantik: header perusahaan, blok tabel item barang, kolom pajak PPN, dan tanda tangan otorisasi. Data mentah diekstrak bukan sekadar string teks panjang, melainkan objek terstruktur berpasangan (key-value pairs).
3. Validasi & Rekonsiliasi Logika Otomatis (Business Logic Cross-Check):
Sebelum data masuk ke database, lapisan validasi matematika memverifikasi angka: apakah perkalian (Kuantitas x Harga Satuan) sama dengan Subtotal? Apakah Subtotal ditambah PPN 11% sesuai dengan Total Akhir? Jika ada selisih, dokumen ditandai untuk tinjauan cepat (*human-in-the-loop*).
4. Ingestion Payload JSON ke Core ERP / Database:
Data final diformat ke dalam skema JSON baku yang langsung dikonsumsi oleh API webhook backend atau sistem ERP korporat (seperti SAP, Oracle, atau PostgreSQL internal) tanpa sentuhan ketik manual.
Integrasi dengan Ekosistem Otomasi dan AI Korporat
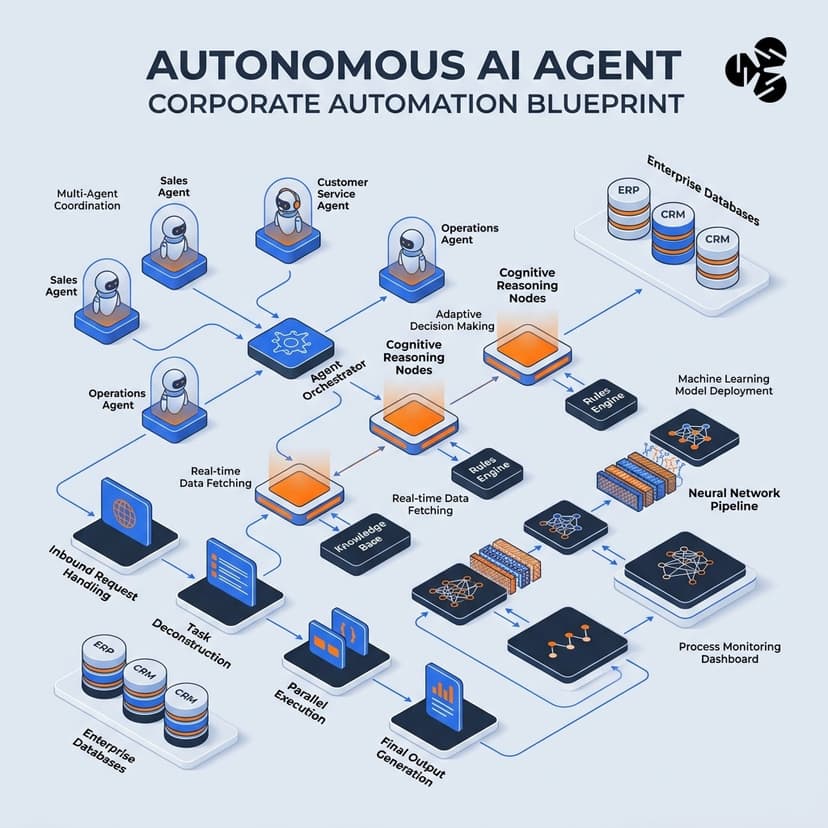
Mengekstrak teks kertas menjadi JSON hanyalah langkah pintu masuk (ingestion) dari modernisasi alur kerja perusahaan. Manfaat terbesar baru tercipta saat data terstruktur ini dihubungkan langsung dengan orkestrasi agen otonom yang dapat mengambil tindakan bisnis lanjutan—seperti validasi PO otomatis, penerbitan approval pembayaran, atau perutean tiket klaim asuransi.
Untuk memahami bagaimana mendesain arsitektur otomasi cerdas end-to-end yang patuh tata kelola data perusahaan, pelajari kerangka kerja kami di Blueprint Implementasi AI untuk Korporat: Dari Otomasi Alur Kerja Hingga Autonomous AI Agent. Panduan ini memberikan peta jalan menyeluruh bagi manajemen dalam mengukur ROI investasi kecerdasan buatan secara terukur.
Tantangan Keamanan Data dan Kepatuhan Regulasi di Indonesia
Dalam mengadopsi AI OCR untuk dokumen sensitif (seperti data e-KTP pelanggan, laporan keuangan, atau rekam medis rumah sakit), pemimpin teknologi di Indonesia wajib mematuhi ketentuan Undang-Undang Perlindungan Data Pribadi (UU PDP). Mengirimkan gambar dokumen yang memuat data pribadi ke API publik tanpa perjanjian pemrosesan data (DPA) tertutup membawa risiko sanksi denda finansial berat.
Perusahaan berskala menengah dan enterprise disarankan memilih arsitektur AI OCR yang dapat dijalankan secara terisolasi (self-hosted / on-premise container) atau menggunakan layanan private cloud dengan enkripsi data saat diam (at-rest) dan saat bergerak (in-transit) dengan jaminan model tidak melatih ulang data pelanggan.
Kesimpulan: Kapan Perusahaan Anda Harus Beralih?
Jika organisasi Anda memproses lebih dari 500 dokumen fisik atau PDF per bulan dan tim operasional menghabiskan lebih dari dua jam sehari hanya untuk menyalin data ke komputer, adopsi AI OCR bukan lagi sekadar eksperimen inovasi—melainkan kebutuhan mendesak untuk menjaga margin efisiensi operasional dan kepuasan tim kerja.
FAQ (Pertanyaan yang Sering Diajukan)
Apakah AI OCR mampu membaca teks tulisan tangan (handwriting) di formulir fisik?
Ya. Berkat arsitektur Intelligent Character Recognition (ICR) berbasis deep learning, model modern dapat membaca tulisan tangan pada formulir isian dengan tingkat akurasi hingga 85%–93%, jauh melampaui OCR konvensional yang kerap gagal total.
Bagaimana jika kualitas foto dokumen buram atau diambil dari sudut miring oleh kamera HP?
Pipeline AI OCR enterprise dilengkapi modul computer vision pra-pemrosesan yang secara otomatis melakukan pelurusan perspektif (perspective correction), denoising, dan penajaman kontras piksel sebelum proses inferensi teks dimulai.
Berapa lama waktu implementasi integrasi AI OCR ke sistem ERP yang sudah berjalan?
Untuk dokumen standar (seperti invoice, receipt, atau faktur pajak), integrasi melalui REST API atau webhook middleware umumnya memakan waktu 2 hingga 4 minggu kerja, mencakup tahap pemetaan skema data JSON dan pengujian akurasi.
Referensi & Tautan Berguna
Dokumentasi Arsitektur Ekstraksi Dokumen AWS Textract: https://aws.amazon.com/textract/
Google Cloud Document AI Framework Overview: https://cloud.google.com/document-ai
Riset Vision Transformer pada Pemrosesan Dokumen oleh Microsoft Research: https://arxiv.org/abs/2105.13532