Lonjakan adopsi retrieval-augmented generation skala besar picu krisis infrastruktur data. Tim enterprise hadapi tagihan komputasi membengkak tanpa penurunan latensi kueri. Pipeline RAG macet saat data lewati jutaan vektor dimensi tinggi. Bottleneck I/O memori dan overhead jaringan buat sistem retrieval lumpuh pada beban puncak.
Evaluasi objektif infrastruktur vector database selesaikan friksi kinerja lewat pemisahan layer indeks, kompresi kuantisasi vektor, dan opsi self-hosted vs managed service. Weaviate unggul pada fleksibilitas hybrid search dan isolasi tenant on-premise, sementara Pinecone tawarkan kemudahan operasional serverless tanpa overhead manajemen kluster.
Simak bedah mendalam metrik latensi, trade-off arsitektur, dan simulasi biaya riil berikut.
Daftar Isi
Krisis Latensi dan Bottleneck Arsitektur Vector DB Korporat
Beban kerja RAG enterprise sering gagal penuhi target service level agreement latensi p99 di bawah 50 milidetik. Masalah utama bersumber dari indeks Hierarchical Navigable Small World konvensional yang rakus RAM. Setiap penambahan jutaan dokumen korporat memaksa alokasi memori eksponensial. Sistem mulai lempar page faults saat working set lampaui batas DRAM mesin host.
Kompleksitas kueri hibrida perparah kondisi. Penggabungan vektor dense dengan BM25 sparse search butuhkan sinkronisasi dua struktur indeks berbeda secara instan. Filter metadata multi-tenant yang ketat sering dieksekusi via post-filtering lambat, bukan pre-filtering tingkat mesin indeks dasar. Hasil kueri tersendat akibat scan linear metadata berulang.
Dampak langsungnya fatal: lonjakan latency tail gagalkan eksekusi autonomous agent berantai. Kegagalan ini mempertegas urgensi pondasi data solid sebagaimana tertuang dalam Blueprint Implementasi AI Korporat: Dari Otomasi Alur Kerja Hingga Autonomous AI Agent. Arsitektur vector DB korporat wajib pisahkan indexing layer dari storage tier guna capai throughput stabil.
Analisis Komparasi: Weaviate vs Pinecone Enterprise
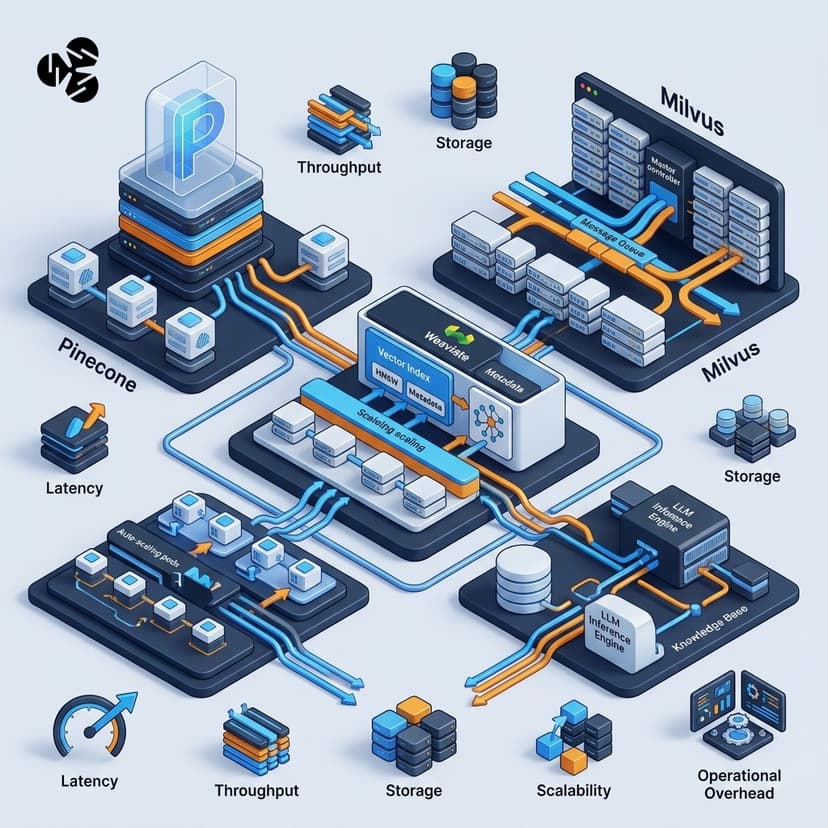
Pertarungan weaviate vs pinecone enterprise berkisar pada kontrol bare-metal melawan kenyamanan serverless murni. Pinecone hilangkan beban orkestrasi node, patch OS, dan tuning sharding manual. Arsitektur serverless Pinecone pisahkan komputasi baca-tulis secara otomatis, ideal bagi korporasi tanpa divisi DevOps khusus vector engine.
Weaviate ambil pendekatan modular berbasis Go. Platform tawarkan kontrol penuh atas storage engine, integrasi modul machine learning lokal via container, dan skema multi-tenancy native. Weaviate izinkan tenant dinonaktifkan ke cold storage berbasis disk (S3/GCS) saat idle, potong konsumsi RAM kluster secara drastis tanpa hapus metadata indeks.
Dari sisi indexing, Weaviate dukung Product Quantization dan Binary Quantization langsung pada graph HNSW. Kuantisasi ini kompres representasi vektor hingga 95 persen dari ukuran asli. Dampaknya, footprint RAM anjlok, latensi search p99 terpangkas, dan throughput query-per-second naik signifikan dibanding engine tanpa kompresi vektor native.
| Fitur Evaluasi | Weaviate (Self-Hosted / Managed) | Pinecone (Serverless Enterprise) | Qdrant / Milvus Alternatif |
|---|---|---|---|
| Deployment Mode | VPC, On-Prem, Managed Cloud | Pure Managed Cloud (SaaS) | VPC, Bare-Metal, Managed |
| Native Multi-Tenancy | Sangat Baik (State Sharding) | Metadata Namespace Isolation | Tergantung Partisi Koleksi |
| Hybrid Search | Dense + BM25 Native Fusion | Sparse-Dense Vectors Terpisah | Tersedia via RRF scoring |
| Kompresi Vektor | PQ, BQ, SQ (In-Memory Engine) | Internal Serverless Index | Scalar, Product Quantization |
| Kontrol Kedaulatan Data | Penuh (Air-gapped ready) | Terbatas pada Region Provider | Penuh (Open-source binary) |
Model Biaya Infrastruktur Weaviate RAG: TCO Cloud vs Self-Hosted
Kalkulasi biaya infrastruktur weaviate rag butuhkan audit menyeluruh atas total cost of ownership. Layanan managed cloud kenakan tarif berbasis request units dan gigabyte storage per jam. Pada volume 50 juta vektor dimensi 1536, tagihan managed cloud bulanan dapat tembus belasan ribu dolar jika kueri agent berjalan paralel tanpa henti.
Self-hosted Weaviate di atas kluster Kubernetes (EKS/GKE) alihkan biaya ke instance compute dan persistent disk. Pemanfaatan Product Quantization memungkinkan korporasi jalankan dataset 50 juta vektor pada kombinasi node memory-optimized yang jauh lebih ramping. Beban biaya RAM turun ke alokasi NVMe disk storage yang signifikan lebih murah.
Namun, opsi self-hosted tuntut alokasi jam kerja tim reliability engineering. Biaya pemeliharaan kluster, backup snapshot, upgrade versi minor tanpa downtime, dan pemantauan metrik Prometheus merupakan variabel TCO riil. Tanpa kompetensi internal, penghematan biaya komputasi bare-metal cepat tergerus oleh ongkos operasional teknis.
Rekomendasi Vector Database AI Agent untuk Workload Skala Besar
Pemilihan engine untuk autonomous agent butuhkan kriteria seleksi yang lampaui sekadar retrieval statis. Rekomendasi vector database ai agent prioritaskan fleksibilitas payload filtering, kecepatan update vektor real-time, dan efisiensi thread concurrency. Agent butuhkan penyimpanan konteks dinamis dengan operasi write-heavy saat merekam trace eksekusi.
Gunakan checklist teknis berikut sebelum finalisasi arsitektur:
- Validasi dukungan native pre-filtering agar kueri tidak jalankan scan brute-force di belakang layar.
- Uji throughput write ingestion tanpa degradasi latensi search paralel pada index yang sama.
- Pastikan ketersediaan isolasi tenant setingkat thread OS untuk jamin kepatuhan data privasi korporat.
- Verifikasi fungsionalitas hybrid sparse-dense tanpa butuh komponen broker middleware tambahan.
Pilihan arsitektur akhir bermuara pada regulasi data dan struktur tim korporasi. Jika kedaulatan data dan cost efficiency volume masif jadi mandat, Weaviate self-hosted berbasis Kubernetes solusi paling terukur. Sebaliknya, bila kecepatan time-to-market jadi prioritas mutlak, solusi fully-managed hilangkan friksi operasional awal.
Referensi & Tautan Berguna
- Dokumentasi Resmi Arsitektur Weaviate: https://weaviate.io/developers/weaviate
- Arsitektur Pinecone Serverless: https://docs.pinecone.io/guides/get-started/overview
- Panduan Vektor Search Qdrant Engine: https://qdrant.tech/documentation/
Pertanyaan Kerap Diajukan (FAQ)
Kapan sebaiknya memilih Weaviate dibanding Pinecone?
Pilih Weaviate jika korporasi butuh isolasi data on-premise/private cloud, efisiensi biaya lewat kuantisasi vektor (PQ/BQ), dan kontrol skema multi-tenancy berbasis status storage.
Berapa persen efisiensi memori yang dihasilkan Product Quantization Weaviate?
Product Quantization (PQ) pada Weaviate mampu mengompresi kebutuhan RAM hingga 70-80 persen, sementara Binary Quantization (BQ) dapat mereduksi ukuran dimensi hingga 95 persen dengan sedikit degradasi recall rate.
Apakah Weaviate mendukung pencarian hybrid tanpa plugin eksternal?
Ya. Weaviate sediakan native hybrid search yang menggabungkan algoritma dense vector index HNSW dengan sparse keyword search BM25 dalam satu query pipeline terpadu.